Tanya Jawab Dokumen PDF dengan AI
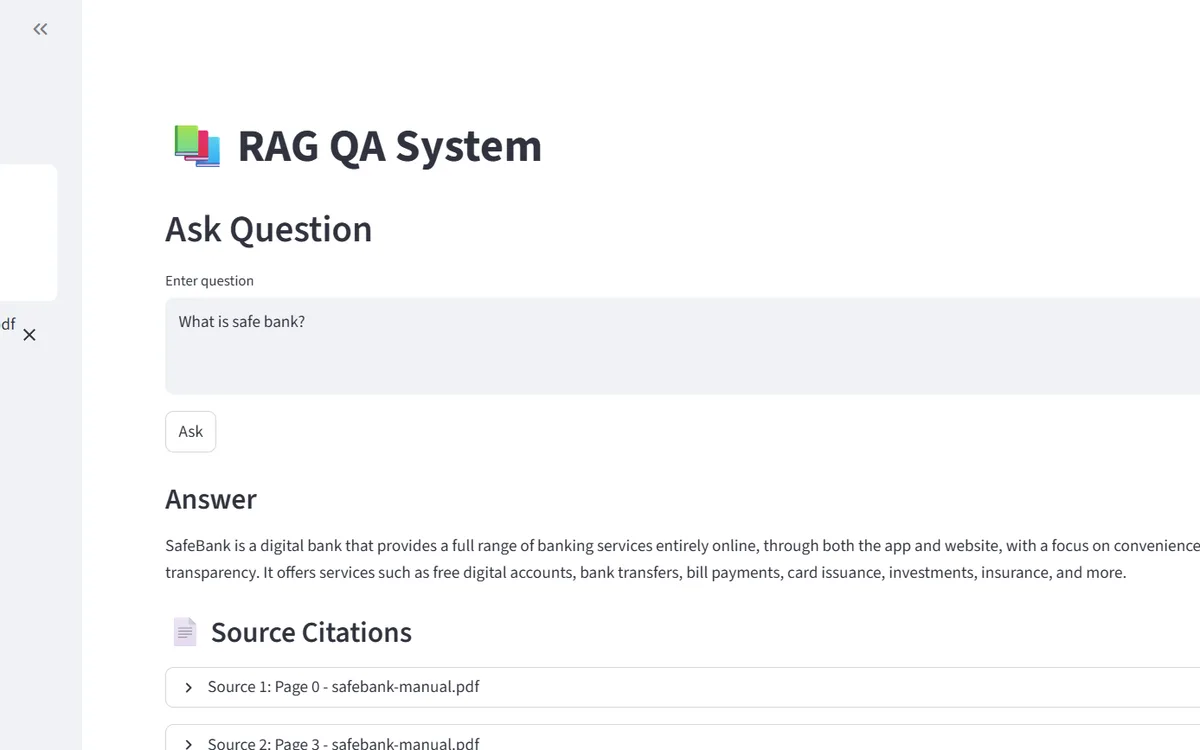
Unggah PDF lalu ajukan pertanyaan: sistem mencari bagian dokumen yang relevan dan AI menyusun jawaban dari isi dokumen itu.
- Status
- Prototipe
- Lapisan
- AIBackendData
- Dipakai oleh
- Staf atau pelanggan yang sering mencari jawaban di manual, SOP, atau kebijakan; saat ini masih berupa prototipe.
Masalahnya
Mencari jawaban di manual, SOP, atau kebijakan yang tebal memakan waktu staf dan sering menghasilkan jawaban yang berbeda-beda.
Solusinya
Dokumen dipecah menjadi potongan, diubah menjadi vektor, dan disimpan di PostgreSQL dengan pgvector. Saat ada pertanyaan, potongan paling relevan diambil lalu model Llama 3.3 lewat Groq menyusun jawabannya.
Cara kerjanya
Apa yang terjadi, langkah demi langkah, dari sudut pandang pengguna.
- 01
Unggah dokumen PDF
Pengguna mengunggah PDF lewat halaman web. Sistem hanya menerima file PDF.
- 02
Dokumen dipotong per bagian
Teks dibaca per halaman, lalu dipecah menjadi potongan pendek yang sedikit tumpang tindih agar konteksnya tidak terputus.
- 03
Potongan diubah menjadi vektor
Setiap potongan diubah menjadi deretan angka yang mewakili maknanya, lalu disimpan di PostgreSQL dengan pgvector.
- 04
Pengguna bertanya
Pengguna mengetik pertanyaan dengan bahasa biasa, misalnya tentang prosedur tertentu di manual.
- 05
Bagian paling relevan dicari
Sistem mengambil beberapa potongan yang maknanya paling dekat dengan pertanyaan, sambil menghindari potongan yang isinya kembar (MMR).
- 06
AI menyusun jawaban
Llama 3.3 lewat Groq menjawab hanya dari potongan tadi. Bila jawabannya tidak ada di dokumen, AI diminta menjawab "tidak tahu".
Desain sistemnya
Siapa yang memakai, apa yang mereka lihat, apa yang bekerja di belakang layar, dan di mana data disimpan. Baca dari kiri ke kanan.
1Pengguna
- Staf atau pelangganMengunggah PDF dan mengajukan pertanyaan
2Yang dilihat
- Halaman StreamlitTempat unggah PDF, kolom pertanyaan, dan jawaban
3Yang bekerja di belakang
- Server APIFastAPI menjalankan alur RAG: cari potongan, lalu minta AI menjawab
- Model embeddingSentence Transformers mengubah teks menjadi vektor makna
- Evaluasi RAGASMengukur apakah jawaban setia pada dokumen dan relevan
4Tempat data dan layanan luar
- PostgreSQL + pgvectorMenyimpan potongan dokumen beserta vektornya agar bisa dicari
- Groq (Llama 3.3)Model AI yang menulis jawaban dari potongan dokumen
Fitur utama
- Unggah PDF lewat web
- Pencarian potongan relevan (MMR)
- Jawaban dari model Llama 3.3
- Evaluasi kualitas dengan RAGAS
- Backend FastAPI, antarmuka Streamlit
Dibangun dengan
- Python
- FastAPI
- Streamlit
- LangChain
- PostgreSQL
- pgvector
- Groq API
- Sentence Transformers
- RAGAS
- MLflow
- PyMuPDF
- Docker
Yang didapat bisnis
- Jawaban diambil dari dokumen resmi, bukan dari ingatan staf yang berbeda-beda.
- Staf tidak perlu membaca ulang dokumen tebal untuk satu pertanyaan.
- AI diarahkan untuk mengaku tidak tahu bila jawabannya tidak ada di dokumen.
- Kualitas jawaban bisa diukur dengan set pertanyaan uji sebelum dipakai luas.
Istilah di halaman ini
- RAG
- Retrieval-Augmented Generation: AI mencari dulu bagian dokumen yang relevan, baru menulis jawaban berdasarkan bagian itu.
- Embedding
- Deretan angka yang mewakili makna sebuah teks, sehingga kalimat yang mirip artinya bisa ditemukan walau kata-katanya berbeda.
- pgvector
- Tambahan untuk database PostgreSQL agar bisa menyimpan dan mencari vektor makna.
- MMR
- Cara memilih hasil pencarian yang relevan sekaligus beragam, supaya AI tidak menerima potongan yang isinya sama.
Bisa dipakai untuk bisnis Anda?
Bisa menjadi asisten internal untuk SOP, manual produk, atau kebijakan perusahaan Anda, sehingga staf dan pelanggan mendapat jawaban yang konsisten dari dokumen resmi.
Konsultasikan proyek ini